BİLİM, İNSANLAR VE KARİYERYeni keşif
Ses kaydında konuşma ile arka planı ayırmak
Bir kayıt sınıftaki konuşmayı yakalar, ama sandalye sesi ve koridor uğultusu da kayda karışabilir. İstenen sesle arka plan sesini ayırmayı öğrenebiliriz.
Yazıyı okuOn üç yaşında dünyanın en güçlü genç satranç oyuncularından biriydi. On yedi yaşında milyonlarca kopya satan bir bilgisayar oyununun yapımında çalıştı. Kurduğu DeepMind, önce dünyanın en zor masa oyununda insan şampiyonu yendi, sonra biyolojinin elli yıllık bir sorununu çözdü ve ona Nobel Ödülü kazandırdı. Demis Hassabis’in oyunlarla dolu hikâyesini anlatıyoruz.
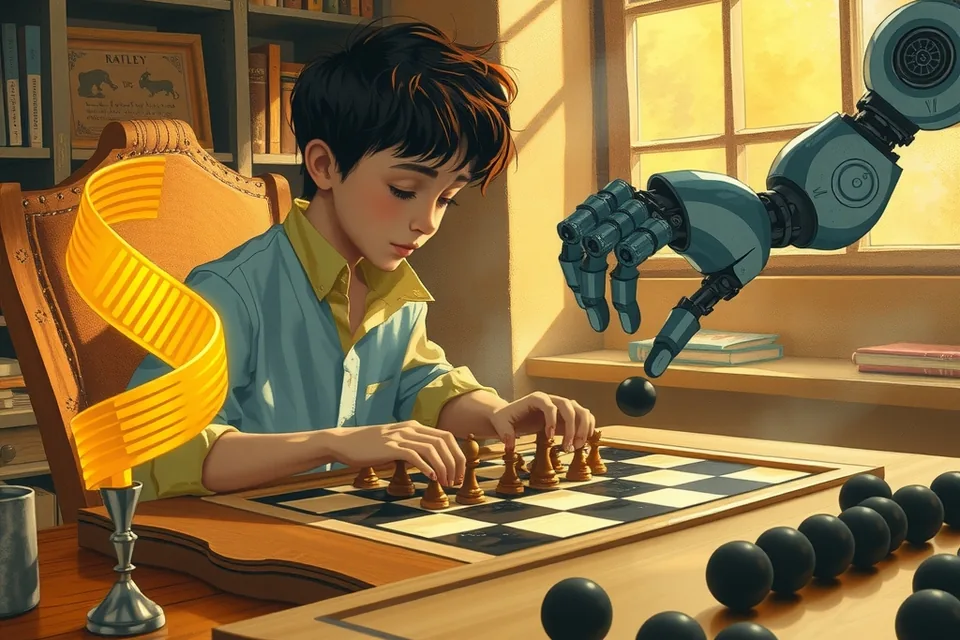
Yapay zekâ denince akla çoğu zaman ChatGPT ve Sam Altman geliyor. Ama yapay zekânın bugünkü hâline gelmesinde çok sayıda araştırmacının ve laboratuvarın payı var. Bunlardan biri, bir bilgisayar oyunu tasarımcısı, bir sinirbilimci ve bir satranç ustası olan Demis Hassabis. Onun hikâyesi özellikle oyun oynamayı seven gençler için ilham verici; çünkü Hassabis’in bütün kariyeri oyunlarla başladı.
Demis Hassabis 27 Temmuz 1976’da Londra’da doğdu. Babası Kıbrıslı Rum, annesi Singapurlu Çin kökenliydi. Dört yaşındayken babasıyla amcasının satranç oynamasını izledi ve kuralları kendisi öğrendi. Kısa süre sonra yetişkinleri yenmeye başladı.
On üç yaşında satranç ustası seviyesine ulaştı ve yaşına göre dünyanın en yüksek puanlı oyuncuları arasında ikinci sıraya yükseldi. Satranç turnuvalarından kazandığı parayla ilk bilgisayarını aldığı anlatılır. Bilgisayara kendi kendine programlama öğrendi ve kendi oyunlarını yazmaya başladı.
Ama satranç ona sadece kazanmayı değil, başka bir şeyi de düşündürdü: Bir insan zihni nasıl planlar yapıyor, hamleleri nasıl seçiyor? Bu soru, onun bütün hayatını yönlendirecekti.
Hassabis okulu yaşıtlarından erken bitirdi. Üniversiteye başlamadan önce bir oyun stüdyosunda çalışmaya başladı ve on yedi yaşında, bir lunapark kurup yönettiğin “Theme Park” oyununun ana yapımcılarından biri oldu. Oyun 1994’te çıktı ve milyonlarca kopya sattı. Oyundaki ziyaretçilerin her biri kendi isteklerine göre davranan küçük bir yapay zekâ ile yönetiliyordu.
Ardından Cambridge Üniversitesi’nde bilgisayar bilimi okudu ve çok yüksek dereceyle bitirdi. Mezun olduktan sonra kendi oyun stüdyosunu kurdu. Stüdyo bazı iddialı oyunlar çıkardı ama ticari olarak zorlandı ve birkaç yıl sonra kapandı.
Bu başarısızlık önemli bir dönüm noktasıydı. Hassabis, yapay zekâyı gerçekten anlamak için önce insan beynini anlaması gerektiğine karar verdi.
Otuz yaşına yaklaşırken Hassabis yeniden öğrenci oldu ve University College London’da bilişsel sinirbilim alanında doktora yaptı. Hafıza ve hayal gücü üzerine çalıştı. Araştırması, beynin geçmişi hatırlamakta kullandığı bölgesinin, geleceği hayal etmekte de rol oynadığını gösteriyordu. Bu çalışma 2007’de bir bilim dergisinin yılın en önemli bilimsel buluşları listesine girdi.
Bu tercih ilginç bir ders veriyor: Bir alanda başarılı olmuşken (oyun tasarımı), tamamen farklı bir alanda (sinirbilim) sıfırdan başlamak. Hassabis bunu yaptı, çünkü asıl hedefine giden yolun oradan geçtiğine inanıyordu.
2010’da Hassabis, Shane Legg ve Mustafa Suleyman ile birlikte Londra’da DeepMind’ı kurdu. Şirketin hedefi çok iddialıydı: Önce zekânın nasıl çalıştığını çözmek, sonra bu bilgiyi diğer her şeyi çözmek için kullanmak.
Peki yapay zekâyı nasıl eğitecekler, nasıl sınayacaklardı? Hassabis’in cevabı tanıdıktı: Oyunlarla. Oyunların net kuralları ve net bir puanı vardır. Bir yapay zekânın ne kadar iyi öğrendiği oyunlarda kolayca ölçülebilir.
DeepMind’ın ilk büyük başarısı, eski Atari oyunlarını sadece ekrandaki pikselleri görerek, kimse kuralları anlatmadan öğrenen bir programdı. Program, deneme yanılma yoluyla onlarca oyunda insan seviyesine ya da üzerine çıktı. Bu yönteme “pekiştirmeli öğrenme” denir: Yapay zekâ, iyi sonuç veren hamleleri ödülle öğrenir. 2014’te Google, DeepMind’ı satın aldı.
Go, siyah ve beyaz taşlarla oynanan, binlerce yıllık bir Asya masa oyunu. Kuralları basit ama olası hamle sayısı o kadar büyük ki bilgisayarların bu oyunda en iyi insanları yenmesinin onlarca yıl sonra mümkün olacağı düşünülüyordu.
Mart 2016’da DeepMind’ın geliştirdiği AlphaGo, dünyanın en iyi oyuncularından biri olan Güney Koreli Lee Sedol ile beş maçlık bir seri oynadı. Maçları dünyada milyonlarca kişi izledi. AlphaGo seriyi 4-1 kazandı.
İkinci maçta AlphaGo’nun yaptığı 37. hamle tarihe geçti. Yorumcular önce bunun bir hata olduğunu düşündü; hiçbir profesyonel oyuncu böyle bir hamle yapmazdı. Sonra hamlenin çok yaratıcı ve güçlü olduğu anlaşıldı. Lee Sedol ise dördüncü maçta kendi “dâhice hamlesi” ile AlphaGo’yu yendi; bu, insanların bu programa karşı kazandığı tek resmi maç oldu. Lee Sedol’un o hamlesi de en az 37. hamle kadar konuşuldu.
Bir yıl sonra DeepMind, AlphaZero’yu geliştirdi. AlphaZero satranç, Go ve shogi oyunlarını sadece kuralları bilerek, kendi kendine milyonlarca maç oynayarak birkaç saat içinde öğrendi ve en güçlü programları yendi. Hassabis’in çocukluğunda sorduğu “zihin nasıl plan yapar?” sorusu, bir makinede başka bir biçimde cevap buluyordu.
Hassabis’in asıl hedefi oyun kazanmak değildi. Oyunlar, gerçek bilimsel sorunlara hazırlık için bir antrenman sahasıydı.
Vücudumuzdaki proteinler, amino asit denilen parçaların uzun bir zincir hâlinde dizilip karmaşık üç boyutlu şekillere katlanmasıyla oluşur. Bir proteinin ne işe yaradığını anlamak için şeklini bilmek gerekir. Ama bu şekli deneylerle bulmak bazen yıllar sürebiliyordu. Bilim insanları elli yıldır, zincir dizilişine bakarak şekli tahmin etmeye çalışıyordu. Buna “protein katlanma problemi” deniyordu.
DeepMind’ın geliştirdiği AlphaFold, 2020’de bu alandaki bilimsel yarışmada çok büyük bir başarı gösterdi ve birçok proteinin şeklini deneylerle bulunan sonuçlara çok yakın tahmin etti. 2022’de DeepMind, bilinen 200 milyondan fazla proteinin tahmini yapısını içeren bir veri tabanını dünyadaki bütün bilim insanlarına ücretsiz açtı. Bugün dünyanın dört bir yanında araştırmacılar bu veri tabanını ilaç ve aşı geliştirmekten, plastiği parçalayan enzimleri incelemeye kadar pek çok çalışmada kullanıyor.
2024’te Demis Hassabis ve DeepMind’dan John Jumper, protein yapısı tahmini çalışmaları nedeniyle Nobel Kimya Ödülü’nü kazandı (ödülün diğer yarısı protein tasarımı çalışmalarıyla David Baker’a verildi). Aynı yıl İngiltere’de “Sir” unvanı aldı.
2023’te Google’ın iki yapay zekâ laboratuvarı birleşti ve Hassabis, Google DeepMind’ın başına geçti. Ekibi bugün Google’ın Gemini yapay zekâ modelleri üzerinde de çalışıyor. Hassabis ayrıca yapay zekâ ile yeni ilaçlar keşfetmeyi amaçlayan Isomorphic Labs adlı şirketi de kurdu.
Hassabis yapay zekânın büyük fırsatlarından olduğu kadar risklerinden de söz eden isimlerden biri. Bu teknolojinin dikkatle, bilimsel bir yöntemle ve uluslararası iş birliğiyle geliştirilmesi gerektiğini savunuyor. Yapay zekâ şirketleri arasındaki hızlı yarışın güvenliği ihmal etmeye yol açabileceği, bu alanda çalışan herkesin hâlâ tartıştığı bir konu.
• Oyunlar ciddi bir öğretmendir. Satranç ona plan yapmayı, Theme Park yazılım geliştirmeyi, Go yapay zekânın sınırlarını sınamayı öğretti.
• Alanları birleştir. Bilgisayar bilimi, sinirbilim ve oyun tasarımını bir araya getirmeseydi DeepMind’ın yolu bu olmazdı.
• Başarısızlıktan yön çıkar. Kapanan oyun stüdyosu, onu beyni anlamaya yönlendirdi.
• Büyük ve anlamlı bir hedef seç. “Zekâyı anla, sonra her şeyi çözmek için kullan” gibi bir hedef, yıllarca sürecek bir yolculuğa güç verir.
• Bilgiyi paylaş. AlphaFold veri tabanının ücretsiz açılması, dünyadaki binlerce araştırmacının işini hızlandırdı.
1. Strateji oyunları oyna ve düşün. Satranç, Go, mangala ya da akıl oyunları oynarken sadece kazanmaya değil, neden kazandığına ya da kaybettiğine de bak. Kaybettiğin bir oyunu baştan oynayıp hatanı bul.
2. Kendi oyununu yap. Scratch ya da benzeri bir araçla, içinde basit kurallarla hareket eden bir “karakter” olan küçük bir oyun tasarla. Karakterin nasıl “karar verdiğini” sen belirle.
3. Biyolojiyi de sev. Yapay zekânın en heyecan verici kullanım alanlarından biri bilim. Kod ile biyolojiyi birleştirenler geleceğin keşiflerini yapacak.
4. Bir öğrenme deneyi yap. Bir arkadaşına kurallarını söylemeden bir oyunu sadece “iyi” ve “kötü” diyerek öğretmeyi dene. Pekiştirmeli öğrenmenin mantığını böyle hissedebilirsin.
5. Merak ettiğin büyük soruyu yaz. Hassabis’in sorusu “zihin nasıl çalışır?” idi. Seninki ne? Defterinin ilk sayfasına yaz.
Demis Hassabis’in hikâyesi bize şunu söylüyor: Oyun oynamak zaman kaybı olmak zorunda değil. Doğru sorularla birleştiğinde, bir satranç tahtası bile insanı Nobel Ödülü’ne kadar götürebilir.
KEŞFE DEVAM
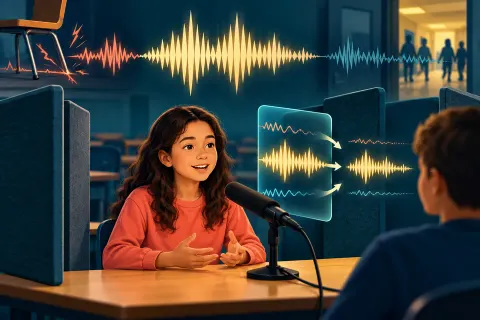
Bir kayıt sınıftaki konuşmayı yakalar, ama sandalye sesi ve koridor uğultusu da kayda karışabilir. İstenen sesle arka plan sesini ayırmayı öğrenebiliriz.
Yazıyı oku
“Bilgisayarcı olacağım” demek, “sporcu olacağım” demeye benzer: Futbolcu da sporcudur, yüzücü de, satranççı da. Bilişim dünyasında da yazılım geliştiriciden siber güvenlik uzmanına, veri bilimciden oyun tasarımcısına onlarca farklı meslek vardır ve her biri bambaşka bir iş yapar. Bu yazıda bir uygulamanın doğuşunu bir hikâye gibi takip ederek bu meslekleri tanıyacak, aralarındaki farkları görecek ve hangisinin sana uygun olabileceğini keşfedeceksin.
Yazıyı oku
On iki yaşında yazdığı bir oyunu bir dergiye sattı, otuzlu yaşlarında bütün parasını iki batmak üzere olan şirkete yatırdı. Elon Musk’ın hikâyesi şanstan çok inatla, hatalardan ders çıkarmakla ve “bu neden bu kadar pahalı?” diye sormakla ilgili. Bu yazıda hayatını, başarılarını, yanlışlarını ve onun çalışma yönteminden senin işine yarayacak dersleri birlikte inceliyoruz.
Yazıyı oku